Avaliação do ChatGPT-4.0 Versus ChatGPT-Mini na Geração de Conteúdo sobre Hipertensão Baseado em Diretrizes
Resumo
Fundamento
Modelos de linguagem baseados em inteligência artificial estão sendo cada vez mais utilizados para gerar materiais de educação em saúde para pacientes. No entanto, sua acurácia, completude e aderência às diretrizes clínicas permanecem incertas.
Objetivos
Comparar o ChatGPT-Mini e o ChatGPT-4.0 na geração de conteúdo educativo sobre hipertensão arterial sistêmica (HAS) quanto à acurácia, completude, qualidade estrutural utilizando o Ensuring Quality Information for Patients (EQIP), consistência das respostas e alinhamento com diretrizes estabelecidas.
Métodos
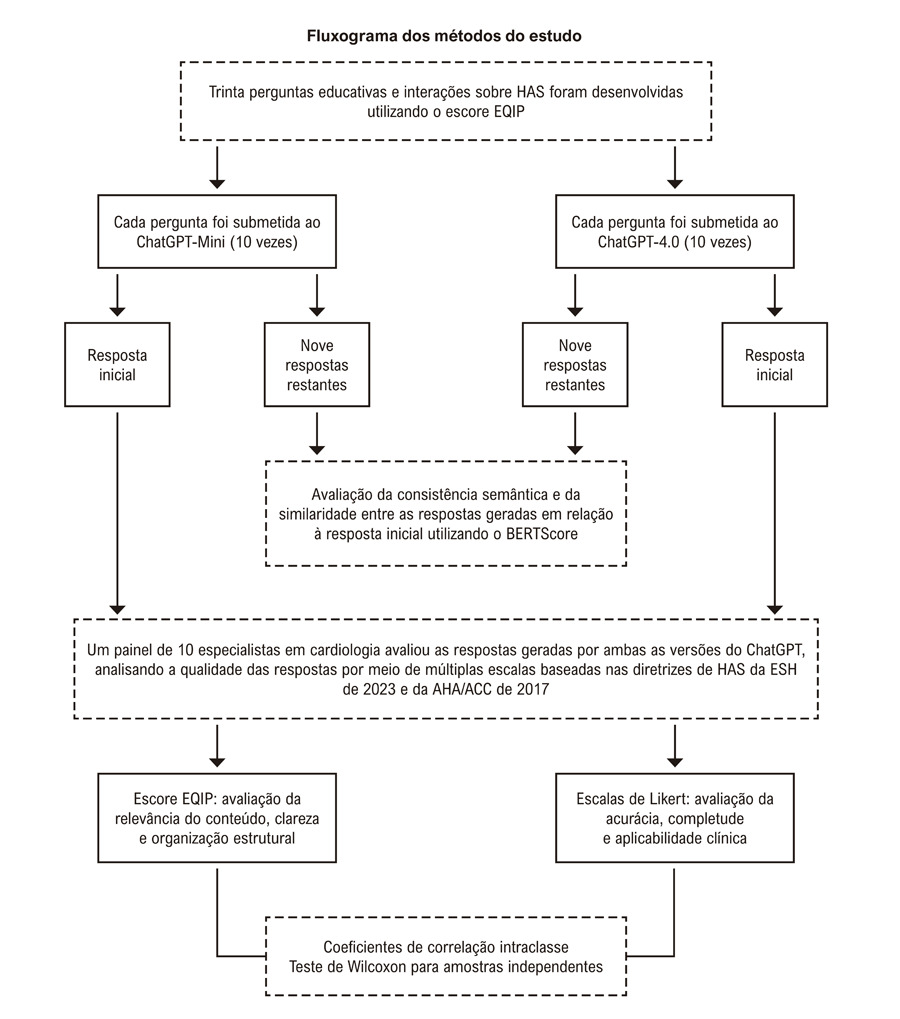
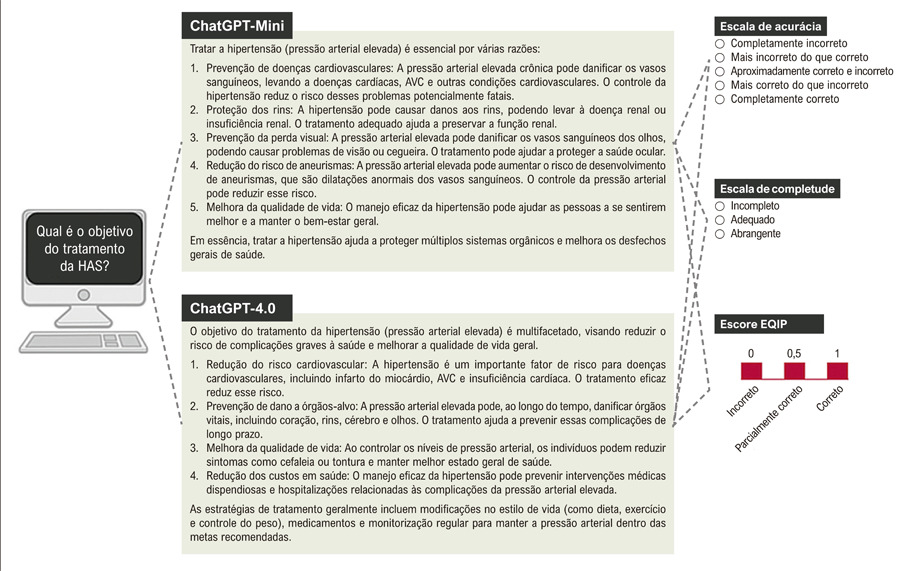
Um conjunto padronizado de 31 perguntas relacionadas à HAS foi submetido a ambos os modelos. As respostas foram avaliadas de forma independente por 10 clínicos cegos, utilizando um escore EQIP modificado, uma escala de acurácia de 5 pontos e uma escala de completude de 3 pontos. A consistência das respostas foi avaliada por meio do BERTScore. As comparações entre os modelos foram realizadas utilizando o teste de Wilcoxon para amostras independentes, bicaudal (p < 0,05). Os tamanhos de efeito foram apresentados como diferenças medianas de Hodges–Lehmann (HL) e delta de Cliff (δ), ambos com intervalos de confiança de 95% (IC 95%). A confiabilidade interavaliadores foi estimada por meio do coeficiente de correlação intraclasse (ICC; modelo de efeitos aleatórios em duas vias, concordância absoluta).
Resultados
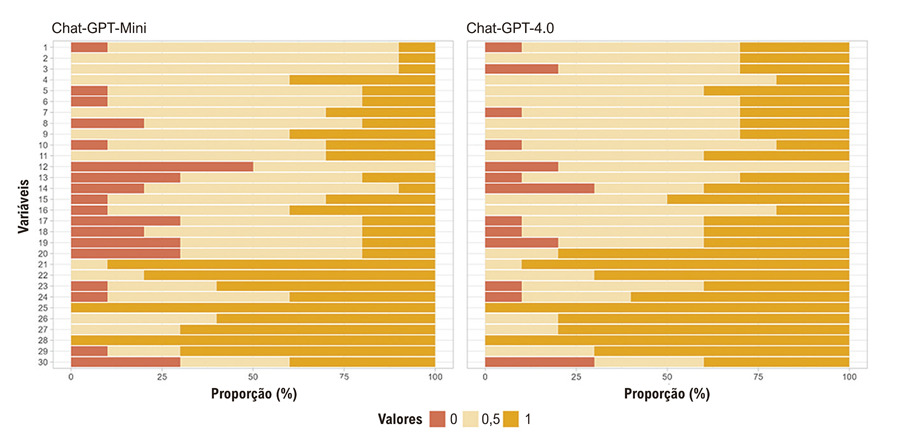
As medidas de tendência central favoreceram o ChatGPT-4.0, embora as diferenças tenham sido pequenas. As medianas foram as seguintes: acurácia, 4,10 (3,70-4,20) versus 3,73 (3,60-4,05); completude, 1,26 (1,17-1,41) versus 1,10 (0,96-1,23); e escore EQIP total, 19,5 (18,0-25,0) versus 18,5 (16,0-23,0) para o ChatGPT-4.0 e o ChatGPT-Mini, respectivamente. As diferenças medianas de HL foram pequenas, com ICs de 95% cruzando zero (acurácia: +0,37, −0,25 a +0,50; completude: +0,16, −0,06 a +0,36; EQIP: +1,0, −1,0 a +6,0). Os valores de δ de Cliff foram consistentemente pequenos e positivos nos desfechos primários, indicando apenas modesta dominância estocástica do ChatGPT-4.0. A clareza de identificação tendeu a ser maior com o ChatGPT-4.0, enquanto a consistência das respostas, medida pelo BERTScore F1, foi geralmente maior para o ChatGPT-Mini (> 0,92 versus 0,885-0,932). A confiabilidade interavaliadores foi de boa a excelente em todas as medidas (ICC > 0,80).
Conclusões
O ChatGPT-4.0 demonstrou melhorias pequenas e não significativas em acurácia, completude e qualidade estrutural em comparação com o ChatGPT-Mini. Os tamanhos de efeito foram modestos, e todos os ICs de 95% incluíram zero. O ChatGPT-Mini produziu respostas mais consistentes. Esses achados ressaltam a importância de relatar rotineiramente tamanhos de efeito com ICs de 95% e apoiam o uso de métodos padronizados de avaliação e de estruturas de validação em tempo real para conteúdo médico educativo gerado por IA.
Imagens
Visualizador da galeria de imagens em tela cheia
Os comentários são moderados pela equipe editorial antes da publicação. As discussões devem ser baseadas em evidências e utilizar linguagem científica. Conflitos de interesse devem ser declarados.